Canvaおじさん
Canvaをすごく使うことになったので作業を定型化、文章化しておく。環境はMacデスクトップアプリ。やりたいことは「白黒画像とカラー画像が混在している。カラー画像はそのままAI動画変換、白黒画像は自動彩色した上でAI動画変換」です。
キャンバスの作成
画像のアップロード
先にデザイン(Canvaにおけるプロジェクトの1単位)を作りたいところですが、画像にフィットしたサイズのために先に画像をアップロードします。

カスタムサイズのキャンバス作成
アップロードしたが画像の右上「…」(ミートボールメニュー)から「Details」を選び画面サイズをメモっておきます。


次にメニューのFile/Create new design/Custom sizeと進んで、メモした画面サイズを指定します。


再度「Uploads」を開き、さきほどの画像を作ったページの上にドロップします。そのあと画像の左上をページの左上隅に合わせて、そのあと画像右下掴んでズームしていくとページの右下にピッタリ合うはずです。
自動彩色
colorify
左側のメニューから「Apps」を選び、検索窓に「Colorify」と入力して選択してください。「Add Color」ボタンから画像を色つけできます。

フェーダーで色味の調整はできますが、Start Over(やり直し)を繰り返しても彩色の結果は変わらなかったと思います。
(ちなみにさっきまでサンプルに使っていた画像がそもそもこのテストに適していないと思ったので変えました)

色がつきました。なかなか思い通りの色にするのは難しいですが、空とか水面を青っぽくするみたいな、一般常識的な部分を優先的に色味強調するとうまくいく気がします。
AI動画変換
画像を選択して「Edit」→「Image to Video」を選択

まずはそのまま変換してみます。

動画になりました。
プロンプト
プロンプトを指定することもできます。

そのまま変換するとカメラ動かしたがるのでそういうのいらない場合は「カメラ固定」などと指定すると抑制されます。あくまで抑制で、少しは動いてしまいます。
これで変換した結果がこちらです。

あとは位置指定(右側の車だけを動かして、など)なども効く気がします。
小ネタ
切り抜き
5秒の動画でも過剰に動いて使いにくければこちらのボタンから指定秒数だけ切り抜きできます。

トリム
画像内の要素が邪魔な場合、例えば写真の中で特に重要な要素でない看板が動画化すると文字化けして邪魔になる、とかそういう場合はトリムするのも手です。ただしトリムしたあとに一度File/Downloadでトリム後のデータをダウンロードし、再度アップロードしてから使いましょう。トリムしただけだと見えない部分に画像は残っているので、動画化するときに思ったような結果になりません。
今日のAI事例。開発環境の最新化

この本を久しぶりに開いてみたが、家のmacだと本の冒頭に書いてある動作環境が合わなかった。sentencepieceのバージョンが合わないだの。Cmakeのバージョン不整合だの。
なのでClaude Codeに調べてもらって合わせてもらった。
プロンプトはこう。
python, cmakeのバージョンを鑑みながら、requirements.txtのバージョンを修正しつつ最新の環境でcondaでllmbookの仮想環境起動するところまでやって。
まずrequirementsの中身を見て利用するライブラリ一覧を見てください。ライブラリは絶対に変えずに、バージョンだけ変えて良いです。pythonは優先的にできるだけ新しいバージョンにしつつ、これらのライブラリもそれに合わせて新しくしたいです。そのバージョンの見当をつけて、requirements.txtに記載のバージョンを変更してください。
condaでllmbookという名前の仮想環境を作ります。そのとき先ほど見当をつけたpythonのバージョンを指定してください。
作った後はconda llmbook activateで仮想環境に入ってください。
入った後、pip install -r requirements.txtでインストールを試みてください。問題なく全て入るまで、調整してください。インターネットで調査してもいいです。
作業の前に、作業リストを作って見せてください。まだ作業はしないで。
とやって、問題ないリストを出してきたので1ステップごとやってもらったら最初にウェブ検索してアタリをつけていたバージョンでライブラリは全て問題なくインストール完了した。
結果はこうです。
macはTahoe 26.3.1で、pythonは3.12.12です。
| # | ライブラリ | 現バージョン |
|---|---|---|
| 1 | accelerate | 1.13.0 |
| 2 | chainlit | 2.10.0 |
| 3 | datasets | 4.7.0 |
| 4 | faiss-cpu | 1.13.2 |
| 5 | html2text | 2025.4.15 |
| 6 | Janome | 0.5.0 |
| 7 | langchain | 1.2.12 |
| 8 | langchain-community | 0.4.1 |
| 9 | langchain-core | 1.2.19 |
| 10 | langchain-openai | 1.1.10 |
| 11 | langchain-text-splitters | 1.1.1 |
| 12 | peft | 0.18.1 |
| 13 | rank-bm25 | 0.2.2 |
| 14 | sentence-transformers | 5.3.0 |
| 15 | sentencepiece | 0.2.1 |
| 16 | torch | 2.10.0 |
| 17 | transformers | 5.3.0 |
| 18 | unstructured | 0.21.5 |
| 19 | wikipedia | 1.4.0 |
で、これで本を読み進めるとlangchainのバージョンが本に記載のものからだいぶ進んじゃって、langchain.text_splitter → langchain-text-splitters に変わってたりするのでその辺りの読み替えが必要になりました。そのあたりもClaude Codeに書き換えてもらってもいいかもしれないけど、それはまた次回やろう
Davinci Resolveでビデオを一定間隔に切り刻む

動画をカットする時、Davinci ResolveのUI上ではbladeという機能を使って任意の場所でビデオクリップを切り離しているように見える。Scripting APIでは、おそらく内部のデータ構造に即した形で「元のクリップを、指定位置の前後に分かれた2つのクリップで置き換える」という形に処理する。
フェード処理(Cross Dissolve)は、UI上ではTransitionのTransition Typeから「Cross Dissolve」を選択する形になるが、APIにはどうもTrasitionを適用する機能がない(!?) これはいいやり方が思い浮かばないので非対応にした。
ビデオを短くして再配置する際、長さの計算にプロジェクトのfpsと動画ファイルのfpsが関わってくる。fpsが異なるとどうしても動画ファイルの再配置時のフレーム数に端数が生じて、実際にDavinci Resolveに合わせて再配置させた際にズレが生じてしまった。ここがうまく解消できなかったので、現状はプロジェクトと動画ファイルのfpsは合わせることが前提となっている。(再配置したあとに各クリップの長さを再取得して、ズレがあった際はクリップの長さを機械的にズレ分を足して再再生成、再々再生成を合うまで繰り返す、とやればできたけど強引すぎるのでやめた)
Davinci Resolve Scripting APIことはじめ
windowsでやりました。(1/14 末尾に追記。macでもやりました。)
資料
- C:\ProgramData\Blackmagic Design\DaVinci Resolve\Support\Developer\Scripting\README.txt
ここにREADMEファイルがあります。Changelogとしての有志の過去ログもあります。
見やすくしたページはこちらになります。
ここに沿ってやっていきます。
環境変数
RESOLVE_SCRIPT_API="%PROGRAMDATA%\Blackmagic Design\DaVinci Resolve\Support\Developer\Scripting"
RESOLVE_SCRIPT_LIB="C:\Program Files\Blackmagic Design\DaVinci Resolve\fusionscript.dll"
PYTHONPATH="%PYTHONPATH%;%RESOLVE_SCRIPT_API%\Modules"
Windowsの環境変数はこうです。ただPYTHONPATHが%RESOLVE_SCRIPT_API%をうまく解決しなかったので
PYTHONPATH=C:\ProgramData\Blackmagic Design\DaVinci Resolve\Support\Developer\Scripting\Modules
としました。(環境変数のロード順が問題になってると思うんだけど、Windows11で環境変数の順番変えるのどうやるんだろう?)
実行環境
ファイルを
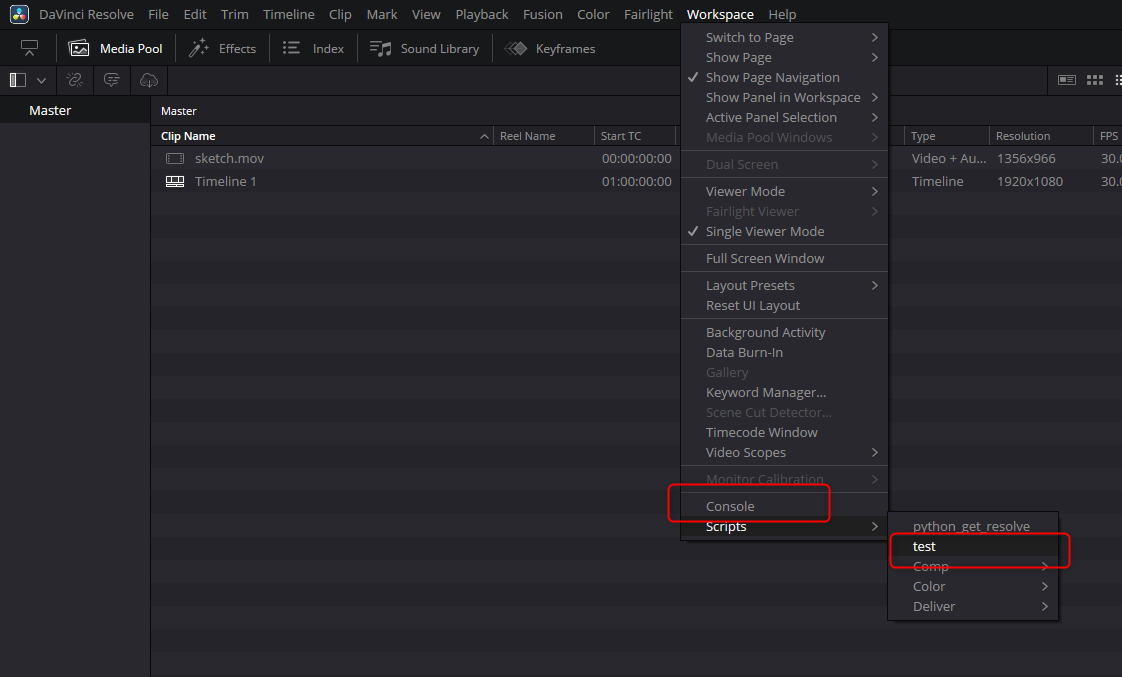
- C:\Users\ユーザー\AppData\Roaming\Blackmagic Design\DaVinci Resolve\Support\Fusion\Scripts\Utility\test.py
に配置すると以下の画像の位置に配置されます。「test」を選択するとスクリプトが実行されます。
また、「Console」を選択すると以下のコンソール画面が表示されます。
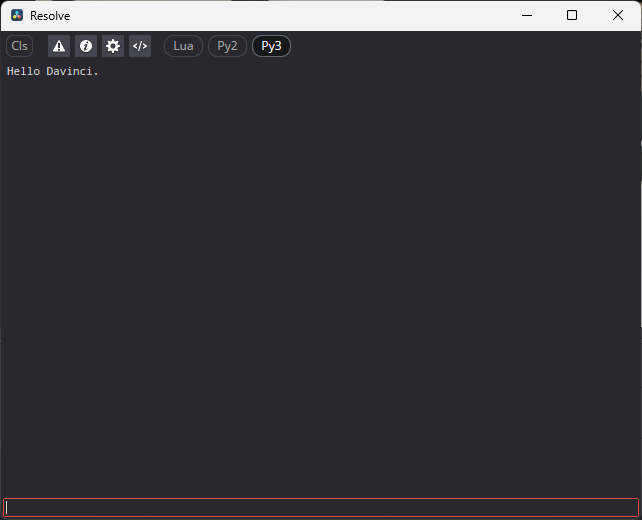
scriptからprintなどしてデバッグしたいときはここにprintの結果やエラーログが出ます。 上は
print("Hello Davinci.")
とした結果です。
スクリプトの書き方
ドキュメントには
#!/usr/bin/env python
import DaVinciResolveScript as dvr_script
resolve = dvr_script.scriptapp("Resolve")
fusion = resolve.Fusion()
projectManager = resolve.GetProjectManager()
projectManager.CreateProject("Hello World")
と書かれているが、dvr_script.scriptapp("Resolve")がどうもオブジェクトを取得できていない様子。
仕方ないので
- C:\ProgramData\Blackmagic Design\DaVinci Resolve\Support\Developer\Scripting\Examples\python_get_resolve.py
を取ってきてtest.pyと同じ場所に置き、以下のようにしました。
from python_get_resolve import GetResolve
resolve = app.GetResolve()
resolve.OpenPage("Edit") # Editモードを選択
ここから始められると思います。
外部から実行する
Claude Codeのようなコーディングエージェントが外部からスクリプトを実行するにはどうすればよいか。
マニュアルには「External scripting using」の設定をすればできる、とあるが、この設定はDavinci Resolve Studio(つまり有料版)でないと表示されないようだ。
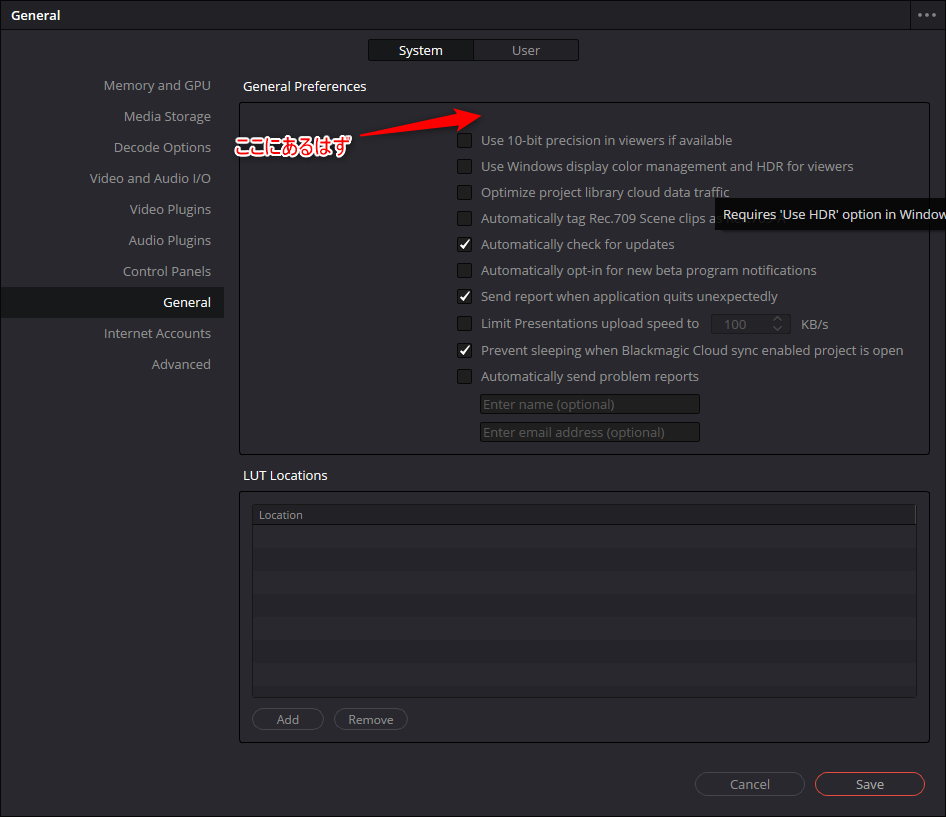
大規模なものを作るときは購入を考えよう。
Macでもやりました
基本的には上記ドキュメントの通りなんですが、MacOS Tahoe 26.2 の環境でDavinci Resolve 19だとドキュメント記載の場所にBlackmagic Designのフォルダが見つかりませんでした。仕方ないので現時点最新のDavinci Resolve20を入れるとフォルダが出てきたのでこれで進めることにしました。
また、所定の場所にスクリプトをおいてもDavinciが認識してくれませんでした。それについては以下で解決しました。
databricksのJOBSコスト調査
放置していたworkspaceでまあまあコスト掛かっていた。
まず左サイドバーからDashboardsを選択し、Workspace Usage Dashboardを見る。
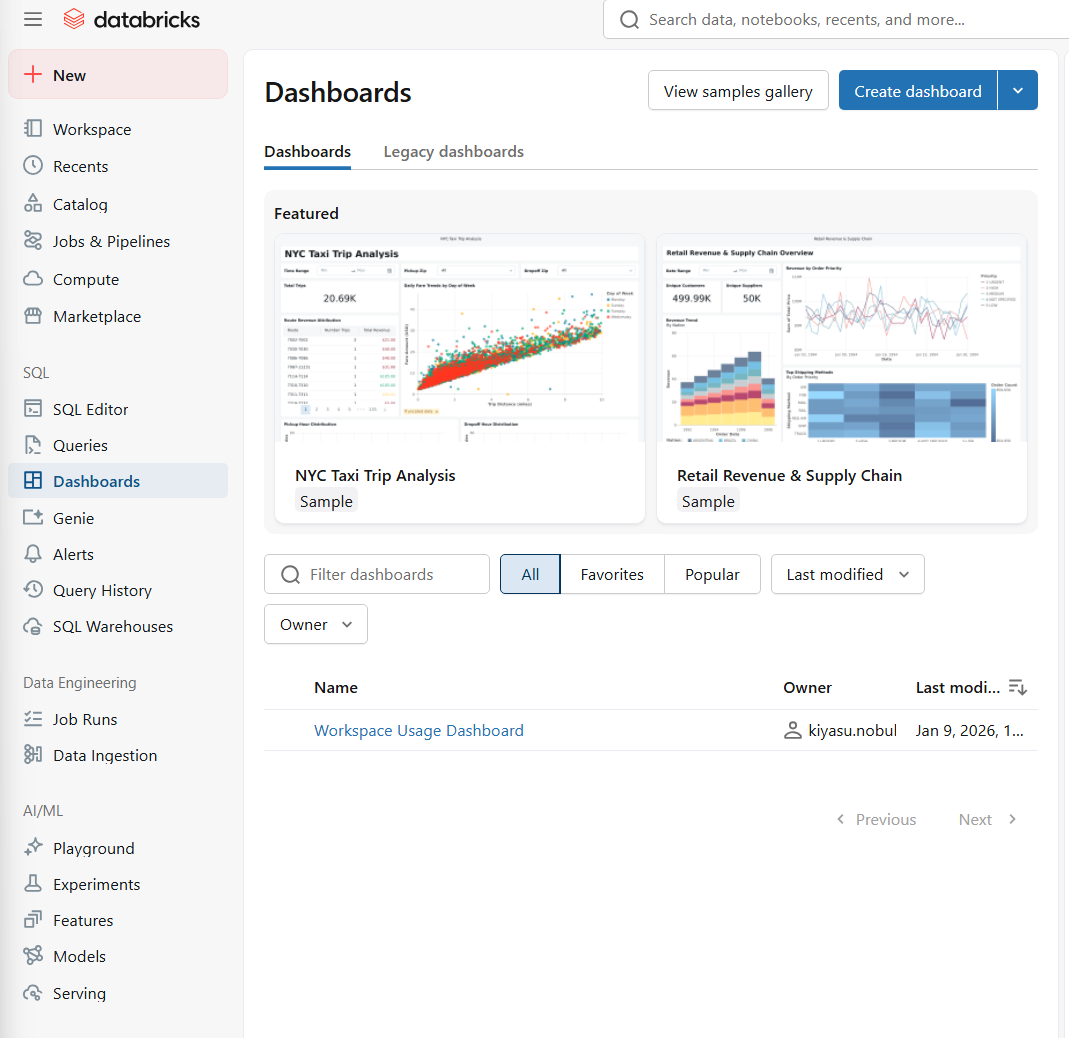
Usage Dashboardが作られてない場合はManage AccountからUsage/Visit new dashboardとすれば作られると思います。

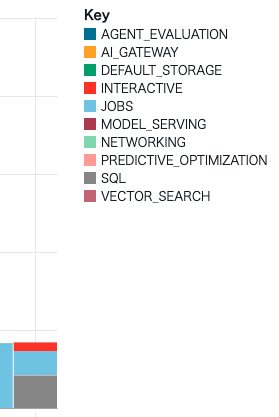
Workspace Usage Dashboard

どうもJOBがずっと動いているようです。
JOBを見に行きましょう。左サイドバーのJob Runsを見ると15分ごとに定期実行されているジョブがありました。Jobの欄にあるJob IDのリンクから詳細画面へ行きます。

Jobの編集
Jobの詳細画面から設定ファイルのYAMLを開きます。

編集画面がこちら。
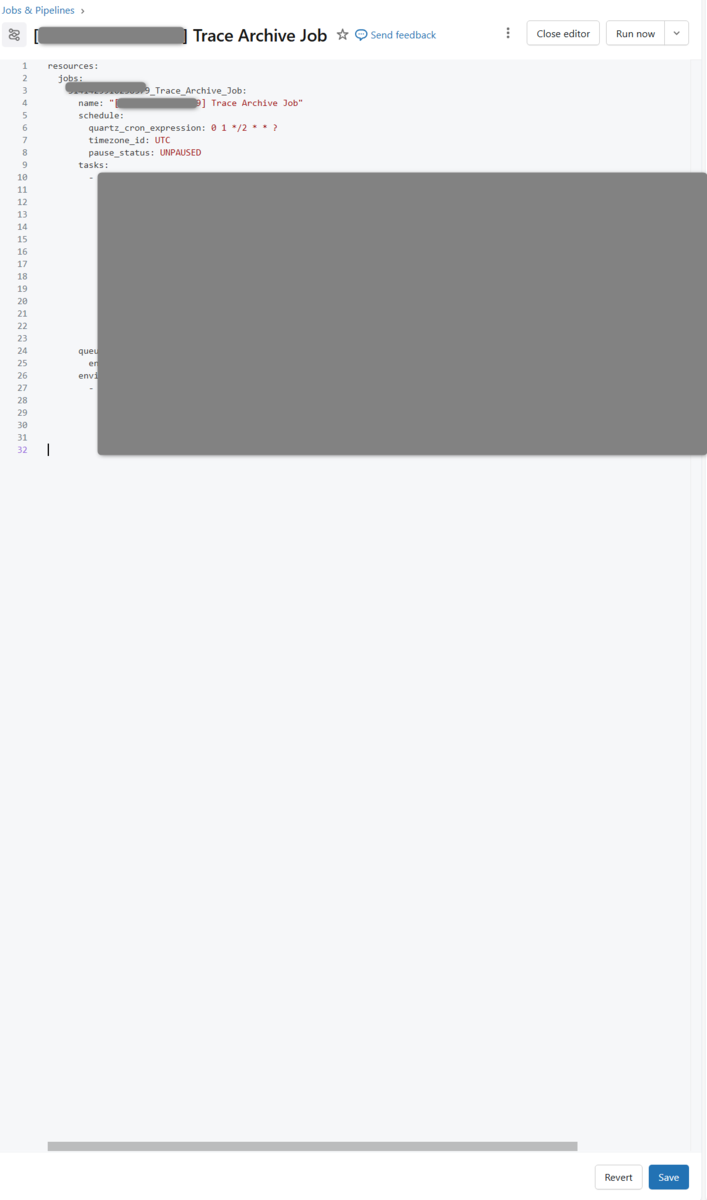
以下の箇所が定期実行を定義していそうです。
      schedule:
        quartz_cron_expression: 0 1,16,31,46 * * * ?
        timezone_id: UTC
        pause_status: UNPAUSED
4時間ごとにしましょう。
      schedule:
        quartz_cron_expression: 0 1 */4 * * ?
        timezone_id: UTC
        pause_status: UNPAUSED
編集画面右下のSaveを押して編集画面を抜けましょう。
Job詳細画面を見ると、どうやら適用されてそうです。

どうもこれはmlflowの定期監視によるJOBで、15分毎実行はどうもデフォルト設定のようです。個人だと結構怖いね…。
AIに聞けば教えてくれるが
これらのことはworkspaceのAI Assistantに聞いたら調べてくれる。
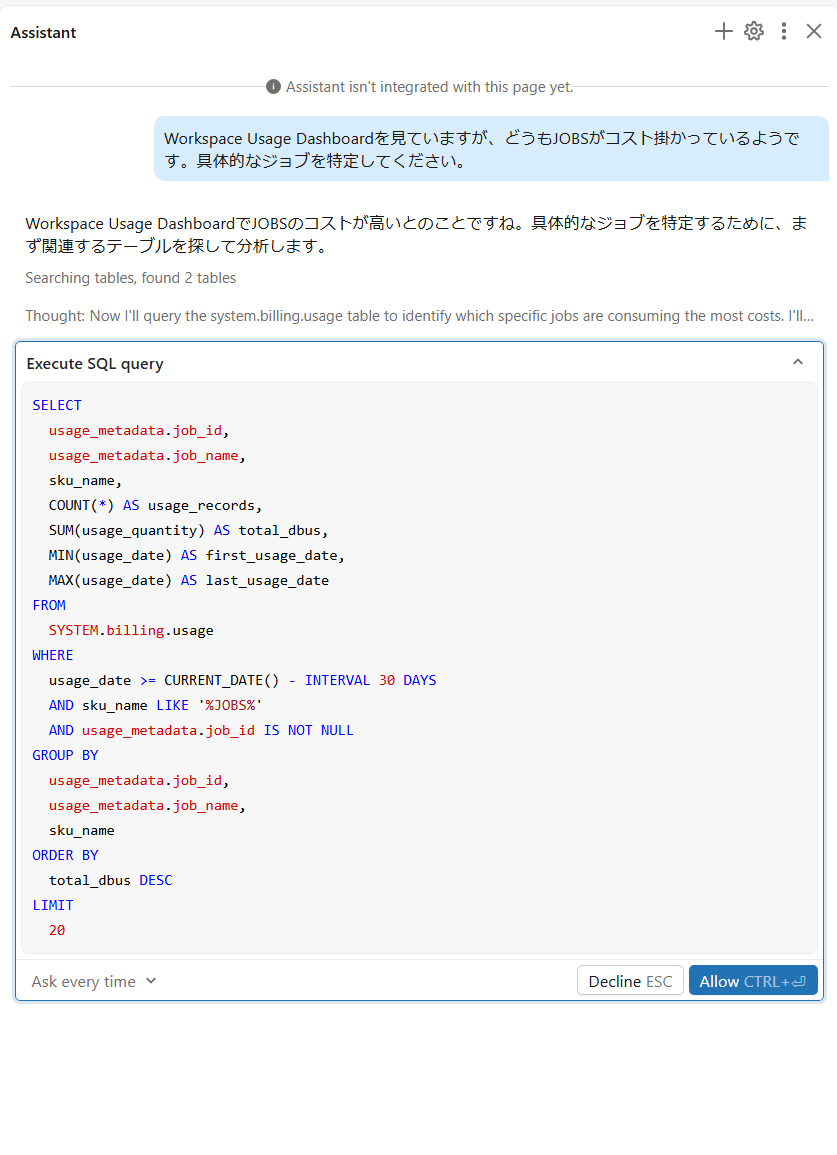
が、その過程で複数SQLを実行して、それがユーザーのコストになるようです。SQL実行前に確認はしてくれます。
DevOps(アプリ開発)からLLMOpsへ
LLM(大規模言語モデル)を含むシステムを、継続的に構築・評価・改善・運用するための仕組みとプロセスをLLMOps と呼ぶ。
自分はもともとDevOpsな開発環境にいて、現在はPoCとしてRAGを作っている。まだLLMOpsの実践までは辿り着けていないが意識はしておきたい。
ソフトウェアの継続的インテグレーションを行うDevOpsや、モデルの学習・評価・デプロイを自動化するMLOpsのように、LLMOpsでは評価の難しいLLMを含むシステムをどのように運用・改善していくか、を体系化する。
LLMOpsはMLOpsの発展形であり、DevOpsと同様に「継続的な改善サイクルと自動化」を重視するが、対象がコードではなくLLMという非決定的モデルである点が異なる。
この記事では、LLMを含んだアプリケーションを開発運用していく中でDevOps(アプリ開発)はLLMOpsのどの立ち位置にいるのか、また、LLMはOpenAIなどのプロプライエタリなAPIを使うことにしてあくまでアプリ開発が中心となる場合、LLMOpsをどのように意識すべきか、について整理していく。
LLMOpsとは
LLMOpsをもう少し詳細に見る。
LLMOpsは、LLMを含むシステムを効率的にデプロイ・監視・改善するためのプラクティス、テクニック、ツールから成る。
LLMOpsは、MLOpsをLLM 特有の運用課題(推論コスト、ドリフト、プロンプト制御など)に対処するよう拡張した形を取る。
LLMOpsは主に以下を含むが、プロジェクトの性質によりフォーカスしたり拡大したりされる。
- モデル構築のためのデータ解析・準備
- プロンプトエンジニアリング
- モデルのファインチューニング
- モデルのレビューとガバナンス
- モデル推論とサービング
人間のフィードバックによるモデルモニタリング
参考
アプリ開発からLLMOpsへ
アプリケーション開発をメイン業務におく組織において、最近の急速な技術の進歩からLLMを積極的にプロダクトに取り入れようとするが、使用するLLM自体はプロプライエタリのAPIを叩いたり、カスタムしてもファインチューニングにとどまる、というケースは少なくないと思う。
その場合に注目すべきLLMOpsの要素は
- プロンプトエンジニアリング
- チェーンとパイプラインの構築
- パフォーマンスチューニング
- 限定的に、選択可能なモデル間で比較することになる
となってくる。
LLMOpsを意識する上で必要となるのは評価方法とツールで、プロンプトエンジニアリングで問題になってくる生成品質については、評価するタスク(翻訳、要約、etc)にもよるがmlflowが幅広いタスクの評価をフォローしてくれる。mlflowは
results = mlflow.evaluate(
    model=model,
    data=eval_data,
    targets="summary",
    model_type="text-summarization"
)

results.metrics # 結果のメトリクスを出力する
のように書く。
パフォーマンスチューニングおよびモデル比較についても同様で、mlflowはModelTrackingという機能でTemperatureなどのパラメータを保存したり、Flavorとして組んだチェーンを保存することができる
英語ですが、このあたりの資料がタスク別の評価方法なども扱っていて面白いです。
まずは LLM関連の評価やパラメータ追跡をmlflowで管理するところから始め、プロンプト改善を継続的に回す、ということが実践的なアプローチかと思う。
LLMOps全体から見たアプリ開発の立ち位置
LLMを含まない(正確にはAIを用いない決定論的な)アプリ開発では、コードを中心にプロダクトの品質向上、運用、経営の判断を巻き込んでいこう、というのがDevOpsの世界観だった。
一方LLMOpsではモデルの機嫌を損ねると大変なことになる。コードはモデルに上座を明け渡し、モデルがコードと運用と経営を巻き込んでいく、という世界観になりそうだ。
コンテンツ開発におけるノード仕様設計のメモ
例えばUnityでメタバースプラットフォームを作り、そのプラットフォーム上でコンテンツをユーザー自身が作る場合、様々な理由からビジュアルプログラミング環境が選ばれることが多い。
プラットフォーマーはそこでいくつかのノードをユーザーに提供する。プラットフォーム固有の機能にアクセスするノードもあれば、コンテンツを作るうえでの便利ノードもある。そのノードの仕様を決めるにあたってのメモ。
設計のタイミング
- × 想像でノード追加する
- ○ プラットフォームの基本機能が出そろい始めてから、実際にコンテンツを作りながら検討する
ユーザーからのリクエストで作るケースも同様に考える。
機能の範囲を意識する
例えば「プラットフォームが独自定義するプロパティを変更する」というノードを考える。
このとき、ノードはひとつではなくふたつにしておく。
- × プラットフォームが独自定義するプロパティを変更するノード
- ○ プラットフォームが独自定義するプロパティ取得するノード + プロパティを変更するノード
変更する対象によっては3つに分割されるパターンもある
- × プラットフォームが独自定義するプロパティを変更するノード
- ○ プラットフォームが独自定義するオブジェクトを取得するノード + オブジェクトからプロパティを取得するノード + プロパティを変更するノード
パラメータのレイヤー
便利ノードを考える。オブジェクト同士の近接判定を行うノードの入力はpositionか、colliderか?
この場合、抽象的か具体的か、どちらかに振る。つまりUnityの場合は
- position or collider
ではなく、まず
- position(collider) or GameObject
の軸で考える。
抽象的(GameObject)にするなら、その分高機能にする
GameObjectを入力にして、position, colliderなどを包括的に扱う、抽象的なインタフェースにする。ひとつのノードで複数サポートする、という方針にする。(enumで判定モードをposition/colliderにしたりするなど)
具体的(Position, Collider)にするなら、単機能で良い
パラメータの種類ごとにノードの数が増える。position対応のノード、collider対応のノード…
こちらのほうが安全ではある。ただしPositionとColliderを近接判定するなら、抽象的にするしかないかもしれない。
リリースとアップデート
ユーザーへすでに提供済みのノードは、変更内容によってはコンテンツの動作に悪影響を与える。 そのため初期の設計とアップデートは慎重に行う必要がある。破壊的変更を行う場合はまず告知し、新旧ノード両方を共存させ、一定期間後に古いノードはサポート外とする。
